
Statisk applikationssäkerhetstestning (SAST) är en central del av utvecklingsprocessen för programvara. SAST-verktyg analyserar källkod för att identifiera säkerhetsbrister och andra problem innan koden kompileras eller exekveras. Detta hjälper utvecklare att hitta och åtgärda problem tidigt…
Etikett: Automation
Bild-till-text AI-modeller: CLIP, BLIP, WD 1.4 (även känd som WD14), SigLIP 2 och ChatGPT med Vision
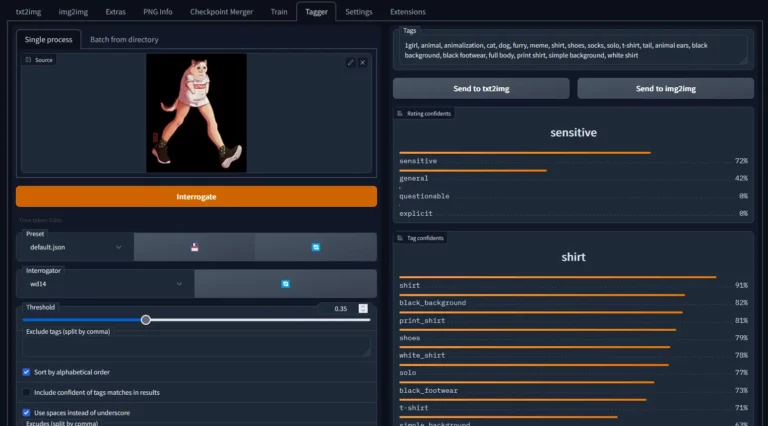
Automatisk taggning, märkning eller beskrivning av bilder är en avgörande uppgift inom många områden, särskilt vid förberedelse av dataset för maskininlärning. Det är här bild-till-text-modeller kommer in i bilden. Bland de ledande bild-till-text-modellerna finns CLIP,…
GPT-4-modeller som lär sig av sina misstag: Ett genombrott inom AI-resonemang

Världen av artificiell intelligens utvecklas ständigt, och ett nyligt genombrott inom AI-forskning har tagit saker till nästa nivå. En ny artikel introducerar ”Reflektion”, en autonom agent med dynamiskt minne och självreflektionsförmåga, vilket gör att AI-modeller…